週末用ChatGPT來看AI ASIC的發展。還試用了AI Agent新功能。用AI模型研究AI晶片,有趣又有收穫。
Inference
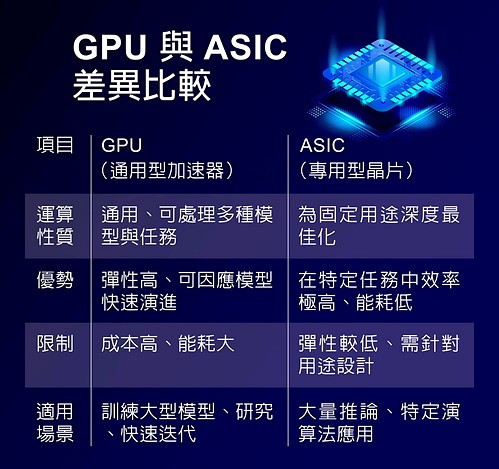
同事們以為四大天王的AI ASIC 是從Training過渡到Inference,這其實是錯誤的。AI ASIC 一般是Inference為主,Training只不適主軸。原因在於inference是個固定並且每天重複千萬次的任務,值得訂做專用晶片;那些時間長,經常改變任務內容的Training就交給GPU。
其次,在2020年前AI的主要功能是分類歸納的「Machine Learning」或是影像語音處理的「Deep Learning」,需要大量的矩陣或張量計算。GoogleTPU(Tensor Process Unit)的命名就可看出其專精張量運算。最早的目的是快速提高搜尋、翻譯及Gmail的效率。Meta的MTIA雖然叫做「META Training Inference Accelerator」,其實優化重點還是在Inference。MTIA的任務是快速提供廣告投送的擊中率,也不脫DL/ML AI。
Memory Wall
隨著能夠進行「創作」的Generative AI出現,用GPU作LLM Inference的成本極高。這兩年ASIC發展已經轉到LLM Inference。其中以AWS的Inferentia v2與GOOGLE TPU-v7拔得頭籌。LLM Infrence任務需要大型Cache Memory,快速緊湊的Pipeline運算。不但使得傳統GPU或TPU的Memory Access遽增,成本極高。也成為新創公司的機會,如 d-Matrix、Tenstorrent 與 Cerebras 等,皆嘗試在「NMC」、「IMC」或新架構上突破。我能見證AI ASIC的誕生與演化,真是一種時代的幸運。
載入留言中……